flexway
FRENParler à un expert

IA

Vos modèles derrière une seule surface, avec un budget qui tient.

Une API compatible OpenAI devant vos fournisseurs et vos modèles internes : budget en jetons et en euros par tenant, repli ordonné avant le premier octet, et jamais un modèle externe pour une requête sensible.

11 livrées sur les 13 présentées · depuis v0.1.0

Ce que vous attendez de ce domaine

  • Centraliser l'accès aux fournisseurs et aux modèles internesLivré · depuis v0.1.0
  • Masquer les clés des fournisseurs, gérer les secretsLivré · depuis v0.1.0
  • Basculer sur panne d'un fournisseurLivré · depuis v0.1.0
Toutes les attentes du marché
Consommation mesuréeConsommation mesurée
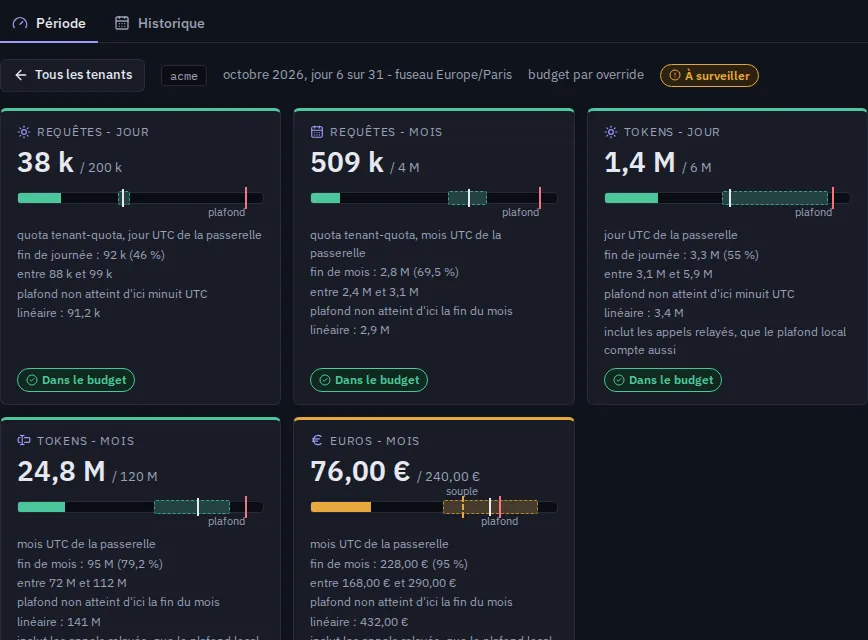
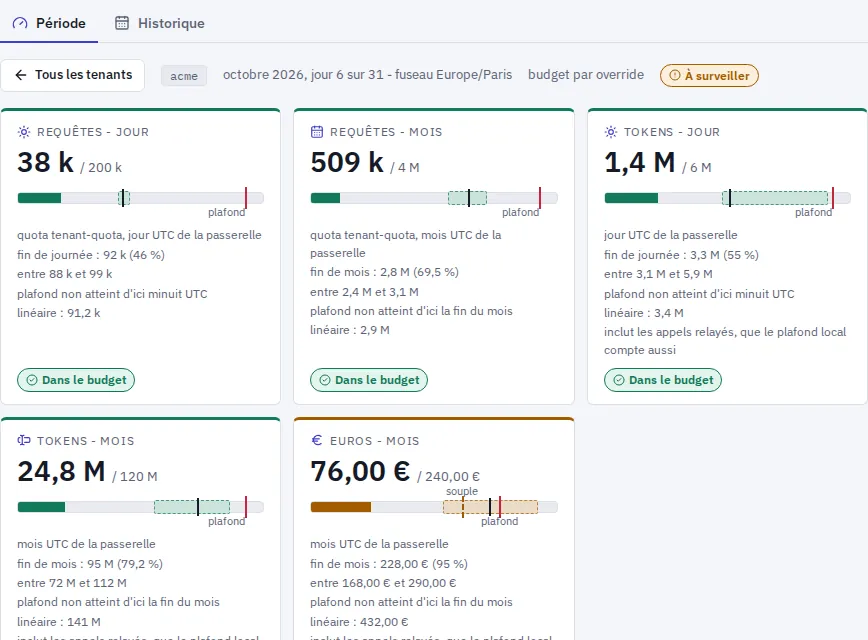
La consommation d'un tenant, mesurée : requêtes, jetons et euros face à leurs plafonds du jour et du mois.Capture réelle, données de démonstration · v1.6.3

Ce que ça résout

Problème 1

La facture d'inférence dérape

Un tenant ou une boucle d'agent consomme sans limite ; la facture arrive en fin de mois.

Réponse de Flexway : Budget mensuel en jetons et en euros par tenant ; plafond souple qui avertit et bascule vers un modèle moins cher.

Problème 2

Une donnée sensible part chez un fournisseur

Une requête qui contient une donnée personnelle part vers un modèle hébergé hors de vos murs.

Réponse de Flexway : Une requête marquée sensible est épinglée sur un modèle interne, ou refusée.

Problème 3

Un fournisseur tombe

Le modèle principal répond en erreur ou dépasse son délai ; l'application échoue.

Réponse de Flexway : Replis essayés dans l'ordre avant tout octet vers le client, coupe-circuit par modèle.

Fonctionnement

Chaque étape est une décision lisible dans la trace et dans la console.

Votre infrastructureflexwayPasserelle API, IA et agentsChaîne de décision unifiée429budget épuisé : 42901 Identité02 Sensibilité03 Routage04 Budget05 Repli06 RelaisApplicationsAgentsModèle externeModèle moins cherModèle interne503Votre infrastructureflexwayPasserelle API, IA et agentsChaîne de décision unifiée42901 Identitétenant lu dans l'identité02 Sensibilitérequête sensible : modèle interne seulement03 Routagebackend par défaut, dérogation ou plafond souple04 Budgetjetons et euros réservés avant l'appel05 Replipanne, 5xx, délai : le suivant06 Relaisflux ligne à ligne, budget réconciliéApplicationsAgentsModèle externeModèle moins cherModèle interne503

IA - Schéma du domaine : qui appelle, les étapes de décision, ce qui est appelé, et le cas de refus.

  • Applications
  • Agents
  1. Identité
  2. Sensibilité
  3. Routage
  4. Budget
  5. Repli
  6. Relais
  • Modèle externe
  • Modèle moins cher
  • Modèle interne

budget épuisé : 429

Applications
Les applications qui appellent vos API : chaque requête passe par Flexway, qui vérifie le contrat et l'identité avant d'atteindre vos systèmes.
Agents
Les agents IA : ils appellent des outils MCP et des modèles par Flexway, sous la même identité, le même quota et le même audit qu'une API.
Identité
Flexway vérifie qui appelle (jeton OIDC, clé d'API ou certificat client) et lit le tenant dans l'identité ; sans identité valide : 401.
Sensibilité
Une requête marquée sensible ne part que vers un modèle interne, jamais vers un fournisseur externe.
Routage
Flexway choisit le modèle par politique : backend par défaut, dérogation déclarée ou plafond souple selon la requête.
Budget
Le budget du tenant, en jetons et en euros, est réservé avant l'appel au modèle ; épuisé : 429 budget_exceeded.
Repli
Si le modèle tombe (panne, 5xx, délai), Flexway passe au suivant avant tout octet renvoyé et le signale dans la réponse.
Relais
La réponse du modèle est relayée sans retenue, flux compris, et le budget est réconcilié au prix réel du modèle qui a servi.
Modèle externe
Un fournisseur de modèle hors de votre infrastructure : appelé sous budget, jamais pour une requête sensible.
Modèle moins cher
Le modèle de repli, moins cher : Flexway s'y replie si le premier tombe, avant tout octet renvoyé.
Modèle interne
Un modèle qui tourne chez vous : les requêtes sensibles n'y quittent jamais votre infrastructure.
  • Ligne : un trajet
  • Correspondance : décision partagée
  • Appel de modèle ou d'outil
  • Refus
  • Votre infrastructure
  1. Identitétenant lu dans l'identité
  2. Sensibilitérequête sensible : modèle interne seulement
  3. Routagebackend par défaut, dérogation ou plafond souple
  4. Budgetjetons et euros réservés avant l'appel
  5. Replipanne, 5xx, délai : le suivant
  6. Relaisflux ligne à ligne, budget réconcilié

En détail

L'essentiel de chaque sujet, avec son statut dans la version publiée ; dépliez une carte pour le texte complet.

Une surface compatible OpenAI, des backends par genre

Livré · v1.5.0

La passerelle sert /v1/* compatible OpenAI sans contrat à écrire, sous la même identité et les mêmes politiques, vers des backends déclarés par genre.

  • /v1/chat/completions, /v1/models, /v1/embeddings intégrés
  • Genres openai, relay, grpc ; aucun fournisseur imposé
  • Streaming relayé ligne à ligne
Voir le détailMasquer le détail - Une surface compatible OpenAI, des backends par genre

La passerelle sert /v1/* sans contrat à écrire : les opérations intégrées ai.chatCompletions, ai.listModels et ai.embeddings répondent sous la section ai de flexway.yaml, avec la même identité, les mêmes politiques et la même trace que le reste du trafic. Les erreurs de /v1/* sont rendues dans l'enveloppe d'erreur OpenAI, refus de la passerelle compris, et en RFC 9457 partout ailleurs. Le streaming est relayé ligne à ligne, sans retenue, et le budget est réconcilié sur l'usage final.

Un backend se déclare par son genre : openai pour toute API compatible OpenAI (le défaut), relay pour une autre Flexway, grpc pour l'amont d'un modèle spécialisé. Aucun fournisseur n'est nommé dans le produit : un backend, c'est une URL, une authentification et un prix. L'authentification est générique - none, bearer par référence, header au nom déclaré, token_file relu à chaque appel comme le projette une identité de charge de travail - et un TLS client peut s'ajouter pour un relais en mTLS.

Le modèle demandé est servi s'il figure dans la liste models du backend, sinon c'est son default_model ; l'audit garde le modèle effectivement servi. Les configurations antérieures se chargent sans changement.

Tous les points

  • /v1/chat/completions, /v1/models, /v1/embeddings intégrés
  • Enveloppe d'erreur OpenAI sur /v1/*
  • Genres openai, relay, grpc ; aucun fournisseur imposé
  • Streaming relayé ligne à ligne

Fonctionnalités et statut

  • Surface compatible OpenAI /v1/*Livré · v0.1.0
  • Backends par genre (OpenAI, relais, gRPC), mesure locale ou amontLivré · v1.5.0
  • Streaming d'inférence relayé sans retenueLivré · v0.1.0
  • Traduction vers l'enveloppe d'erreur OpenAI sur /v1/*Livré · v0.1.0
Lire dans la documentation : Inférence compatible OpenAI

Budgets en jetons et en euros, plafond souple

Livré · v0.1.0

Flexway compte en jetons et en euros par tenant, bascule vers un backend plus économique au plafond souple et refuse en 429 au plafond dur.

  • Jetons (jour, mois) et euros (mois) par tenant
  • Plafond souple : avertir et basculer ; plafond dur : 429
  • Réservation rendue sur échec ou refus
Voir le détailMasquer le détail - Budgets en jetons et en euros, plafond souple

Un quota en requêtes par seconde ne dit rien du coût d'un appel à un modèle. Flexway compte en jetons par jour et par mois, et en euros par mois, par tenant : chaque backend déclare son prix (euros par million de jetons en entrée et en sortie), et le premier budget atteint décide. Chaque appel est pré-réservé puis réconcilié au prix du backend qui a réellement servi.

Au plafond souple (ai.budget.soft), la réponse porte l'en-tête Flexway-Budget: soft et le trafic bascule vers le backend déclaré, plus économique ; au plafond dur, la requête est refusée en 429 budget_exceeded. Un appel en échec ou refusé rend sa réservation, jetons et euros : un backend en panne n'épuise pas le budget d'un tenant. Des dérogations par tenant et par agent fixent un autre backend et d'autres budgets.

Derrière un relais vers une autre Flexway qui mesure elle-même (metering: upstream), le plafond local reste appliqué, le refus 429 de l'amont est relayé tel quel et les séries portent metered_by="upstream", pour qu'une consommation ne soit comptée qu'une fois là où elle est payée. flexway validate avertit d'un relais mesuré localement, qui compterait deux fois.

Tous les points

  • Jetons (jour, mois) et euros (mois) par tenant
  • Plafond souple : avertir et basculer ; plafond dur : 429
  • Réservation rendue sur échec ou refus
  • Dérogations par tenant et par agent

Fonctionnalités et statut

  • Budget et débit par tenantLivré · v0.1.0
  • Quotas en tokens et budget monétaire d'inférenceLivré · v0.1.0
Lire dans la documentation : Servir l'inférence

Requêtes sensibles et souveraineté

Livré · v0.1.0

Une requête marquée sensible ne va qu'à un backend interne, sinon elle est refusée : l'en-tête resserre le routage, jamais ne l'élargit.

  • Requête sensible : backend interne, sinon refus
  • Backend sensible externe refusé au chargement
  • Choix déclaratif et reproductible
Voir le détailMasquer le détail - Requêtes sensibles et souveraineté

Une requête marquée sensible par l'en-tête déclaré (ai.sensitive_header) est épinglée sur le backend interne désigné (ai.sensitive_backend). Ce backend doit être interne : en déclarer un externe est refusé au chargement. S'il n'existe pas de backend interne capable de servir, la requête est refusée plutôt qu'envoyée dehors. L'en-tête ne peut que resserrer le routage, jamais l'élargir.

Un relais vers une autre Flexway est considéré comme externe sauf déclaration contraire (external: false) : seul l'exploitant décide qu'une autre passerelle peut recevoir le sensible. L'identité de l'appel lui est transmise sous les seuls noms déclarés (identity_headers : tenant, agent, sensible) ; rien de la requête de l'appelant n'est recopié. La bascule du plafond souple et les replis ne mènent jamais une requête sensible vers un externe.

Le choix du backend est déclaratif : défaut, puis dérogation du tenant et de l'agent, puis dérogation de capacité, puis sensibilité ; ni la latence, ni le contenu, ni le modèle demandé ne choisissent. Déclarer quel backend sert quels tenants vous aide à répondre à vos exigences de résidence des données ; le routage automatique par latence ou par juridiction est à venir.

Tous les points

  • Requête sensible : backend interne, sinon refus
  • Backend sensible externe refusé au chargement
  • Relais externe par défaut, identité sous noms déclarés
  • Choix déclaratif et reproductible

Fonctionnalités et statut

  • Requêtes sensibles épinglées, souveraineté et repli par politiqueLivré · v0.1.0
  • Routage par politique entre fournisseurs et modèlesLivré · v0.1.0
Lire dans la documentation : IA et inférence

Repli ordonné et coupe-circuit par backend

En partie

Sur panne, 5xx ou délai dépassé, les replis déclarés sont essayés dans l'ordre avant tout octet envoyé, jamais sur un 4xx ni vers un externe pour le sensible.

  • Replis dans l'ordre, avant tout octet
  • Jamais sur 4xx, jamais vers un externe si sensible
  • Réponse marquée Flexway-Degraded
Voir le détailMasquer le détail - Repli ordonné et coupe-circuit par backend

Chaque backend déclare une liste de replis (fallback), essayée dans l'ordre sur erreur de connexion, 5xx, délai dépassé ou circuit ouvert. Le repli a lieu avant tout octet envoyé au client, chaque backend une seule fois. Il n'a jamais lieu sur un 4xx, y compris le 429 d'un fournisseur, et jamais vers un externe pour une requête sensible. La réponse servie par un repli porte Flexway-Degraded: backend-fallback.

Un coupe-circuit par backend évite d'insister sur un modèle qui ne répond plus. Le repli vaut pour les genres openai et relay et ne retient que les backends qui servent la capacité demandée : une requête avec image ne se replie que vers un backend vision. Le repli sur budget épuisé est le plafond souple, décrit plus haut.

Le routage conscient de l'inférence - selon le modèle, la criticité de la requête, la charge réelle du serveur de modèle ou l'affinité de cache de contexte, en s'interfaçant avec la Gateway API Inference Extension sur Kubernetes - est à venir. Le cache sémantique, opt-in par opération, est également à venir.

Tous les points

  • Replis dans l'ordre, avant tout octet
  • Jamais sur 4xx, jamais vers un externe si sensible
  • Réponse marquée Flexway-Degraded
  • Routage conscient de l'inférence : prévu
  • Cache sémantique : prévu

Fonctionnalités et statut

  • Routage par politique entre fournisseurs et modèlesLivré · v0.1.0
  • Requêtes sensibles épinglées, souveraineté et repli par politiqueLivré · v0.1.0
  • Routage conscient de l'inférence (Gateway API Inference Extension)Prévu
  • Cache sémantique, par opérationPrévu
Lire dans la documentation : Servir l'inférence

Audit de métadonnées, jamais d'invite

Livré · v1.5.0

Chaque appel d'inférence laisse une ligne d'audit en métadonnées - tenant, modèle, jetons, coût - sans jamais collecter l'invite ni la réponse.

  • Métadonnées seulement : aucune invite, aucune réponse
  • Modèle servi, jetons et coût par appel
  • Restitution par tenant depuis l'audit
Voir le détailMasquer le détail - Audit de métadonnées, jamais d'invite

Chaque appel d'inférence produit une ligne d'audit en métadonnées : tenant, agent, modèle servi, backend, jetons, coût. L'invite et la réponse ne sont jamais collectées, et les identifiants sont hachés dans les journaux. La restitution par tenant, pour la facturation interne ou la refacturation, sort de cet audit sans outillage à côté.

Les mêmes faits alimentent les métriques flexway.inference.cost et flexway.inference.calls, avec les dimensions metered_by et capability, que la console lit pour ses jauges par tenant et par backend. Garder une trace exploitable de qui a appelé quel modèle, à quel coût, sans conserver le contenu, vous aide à répondre aux exigences de journalisation et de gouvernance des données qui s'appliquent aux usages de l'IA.

Tous les points

  • Métadonnées seulement : aucune invite, aucune réponse
  • Modèle servi, jetons et coût par appel
  • Restitution par tenant depuis l'audit
  • Métriques flexway.inference.*

Fonctionnalités et statut

  • Audit de métadonnées, jamais d'inviteLivré · v0.1.0
  • Backends par genre (OpenAI, relais, gRPC), mesure locale ou amontLivré · v1.5.0
Lire dans la documentation : IA et inférence

Multimodal, embeddings et modèles spécialisés

Livré · v1.5.0

Images, embeddings et modèles gRPC spécialisés sont mesurés sur le budget du tenant, chacun servi par un backend de la capacité demandée.

  • Une image ne va qu'à un backend vision
  • Embeddings avec budget, repli et audit
  • Modèle gRPC spécialisé mesuré par appel ou par octet
Voir le détailMasquer le détail - Multimodal, embeddings et modèles spécialisés

Le contenu d'un message peut être une chaîne ou des parties text et image_url, au format OpenAI. L'image est mesurée dans le corps sans être décodée (ai.vision.max_image_bytes, 8 Mio par défaut ; corps borné par ai.vision.max_body_bytes, 24 Mio par défaut) ; les URI data: sont admises par défaut, une URL distante seulement depuis une origine https déclarée (ai.vision.allowed_origins), et toute autre partie est refusée. Une image ne va qu'à un backend de capacité vision, sinon 400 capability_unavailable ; elle est pré-réservée à 2 048 jetons, réconciliés sur l'usage rendu.

POST /v1/embeddings suit le même chemin qu'une complétion : identité, budget sur prompt_tokens, repli avant tout octet, audit des métadonnées, et un backend de capacité embeddings. Une méthode gRPC d'un modèle spécialisé est mesurée quand elle porte l'option ai de (flexway.v1.operation), l'équivalent gRPC de x-flexway-ai : par appel (corps jamais lu) ou par octet, avec un prix pour mille et une fonctionnalité.

Pour ces modèles, le budget en euros du tenant est réservé avant l'appel et rendu si l'amont n'a pas servi ; les refus sont RESOURCE_EXHAUSTED budget_exceeded et PERMISSION_DENIED sensitive_no_internal_backend. Leur amont doit être nommé par un backend kind: grpc, sinon la configuration est refusée au chargement.

Tous les points

  • Images image_url : data: par défaut, origines https déclarées
  • Une image ne va qu'à un backend vision
  • Embeddings avec budget, repli et audit
  • Modèle gRPC spécialisé mesuré par appel ou par octet

Fonctionnalités et statut

  • Contenu multimodal compatible OpenAI, backend visionLivré · v1.5.0
  • Embeddings, avec budget et auditLivré · v1.5.0
  • Méthode gRPC d'un modèle spécialisé, mesurée par appelLivré · v1.5.0
Lire dans la documentation : Servir l'inférence

Configuration

L'exemple ai-cost, tel qu'il est livré avec Flexway v1.6.3.

examples/ai-cost/flexway.yaml
# What inference costs, and what happens when a backend fails: prices declared per backend, a
# monthly budget in euros per tenant beside the token budget, a soft cap that warns and moves the
# call to a cheaper backend, and fallbacks tried in order before any byte reaches the client - never
# an external one for a sensitive request.
version: 1
auth:
  issuers:
    - name: customers
      discovery: https://login.example.net/.well-known/openid-configuration
      audience: api
      tenant_claim: org
ai:
  security:
    - oidc: { scopes: [inference] }
  sensitive_header: X-Sensitive
  default_backend: eu-large
  sensitive_backend: on-prem
  backends:
    eu-large:
      url: https://api.provider.example/v1
      api_key: "file:/etc/flexway/secrets/provider-key"
      default_model: mistral-large
      external: true
      price: { input_per_mtok: 2.00, output_per_mtok: 6.00 }   # euros per million tokens
      fallback: [eu-small, on-prem]              # in order, on connection failure, 5xx, timeout
    eu-small:
      url: https://api.provider.example/v1
      api_key: "file:/etc/flexway/secrets/provider-key"
      default_model: mistral-small
      external: true
      price: { input_per_mtok: 0.10, output_per_mtok: 0.30 }
      fallback: [on-prem]
    on-prem:
      url: http://vllm.inference.svc:8000/v1
      default_model: mistral-7b-instruct
      price: { input_per_mtok: 0, output_per_mtok: 0 }      # 0 is a price: internal
  budget:
    store: "${COUNTERS_URL}"
    monthly_tokens: 40000000                     # both budgets hold: the first reached decides
    monthly_eur: 50                              # per tenant, over the calendar month
    soft: { at: 0.8, backend: eu-small }         # past 80 %: Flexway-Budget: soft, moved to eu-small
  overrides:
    - { match: { tenant: acme }, monthly_eur: 500 }

Fonctionnalités

Ce qui est livré dans la version publiée v1.6.3, et ce qui vient ; une fonctionnalité n'est jamais présentée comme livrée avant sa version.

FonctionnalitéStatut
Surface compatible OpenAI /v1/*Livré · v0.1.0
Routage par politique entre fournisseurs et modèlesLivré · v0.1.0
Budget et débit par tenantLivré · v0.1.0
Requêtes sensibles épinglées, souveraineté et repli par politiqueLivré · v0.1.0
Audit de métadonnées, jamais d'inviteLivré · v0.1.0
Streaming d'inférence relayé sans retenueLivré · v0.1.0
Contenu multimodal compatible OpenAI, backend visionLivré · v1.5.0
Embeddings, avec budget et auditLivré · v1.5.0
Backends par genre (OpenAI, relais, gRPC), mesure locale ou amontLivré · v1.5.0
Méthode gRPC d'un modèle spécialisé, mesurée par appelLivré · v1.5.0
Routage conscient de l'inférence (Gateway API Inference Extension)Prévu
Cache sémantique, par opérationPrévu
Consommation : requêtes, jetons, euros, par tenantLivré · v0.1.0

Toutes les fonctionnalités · Chiffrer votre budget d'IA

Les autres attentes de ce domaine

  • Frontend augmenté par l'IA sans clé fournisseur, flux, limitesLivré · depuis v0.1.0
  • Droits par équipe, application, modèle ou environnementPortées par opération, dérogations par tenant et par agent, modèles admis par backend ; manquent les modèles admis par appelant (tenant, plan, cas d'usage, client)En partie · suite en 1.9
  • Choisir le modèle selon la tâcheRoutage par capacité (chat, vision, embeddings) ; alias de modèle et cas d'usage cadrés ; manquent les routes par tâche déclaréeEn partie · suite en 1.9
  • Choisir selon latence, coût, qualité ou régionCoût : plafond souple qui bascule ; manquent latence mesurée, coût déclaré, région et classe d'hébergement comme critères déclarés. La qualité n'est pas mesurable par la passerelle (évaluation : hors périmètre)En partie · suite en 1.9
  • Envoyer les demandes simples vers un petit modèlePossible par route déclarée (la tâche le dit) ; un classifieur sur le chemin est exclu par une règle du produitEn partie · suite en 1.9
  • Distinguer modèles cloud, privés et locauxAttribut external des backends et épinglage du sensible ; manque la classe d'hébergement déclarée (cloud, private, local)En partie · suite en 1.9
  • Empêcher l'envoi de données confidentielles à certains fournisseursRequête marquée sensible épinglée sur un backend interne ; manquent des classes de données et les backends admis par classeEn partie · suite en 1.9
  • Gouverner l'accès RAG (recherche, vecteurs, embeddings)Embeddings sous budget, API de recherche et bases vectorielles servies comme des opérations ; le filtrage des droits par document est hors périmètreEn partie · suite à dater
  • Industrialiser le cycle de vie des promptsConfiguration versionnée dans Git, modèles admis par backend ; modèles approuvés par appelant prévus ; registre de prompts et comparaison des résultats : hors périmètreEn partie · suite en 1.9
  • Réduire latence et coûts (cache, petit modèle)Cache de réponses REST ; cache sémantique prévu ; routes par tâche prévuesEn partie · suite en 1.9
  • Coexistence cloud et sur siteÉpinglage du sensible sur un modèle interne, relais vers une autre Flexway ; classes de données et hébergement prévusEn partie · suite en 1.9
  • Routage sémantique, sélection selon tâche, sensibilité, budget, latencePrévu par règles déclarées ; une sélection autonome par un modèle est exclueEn partie · suite en 1.9
  • IA en périphérieLe même binaire arm64 route vers un modèle local ; l'exécution du modèle reste au runtime d'inférenceEn partie · suite à dater
  • Passerelle orientée intention métierL'intention déclarée (cas d'usage, route de tâche) se résout par règle ; jamais par un modèleEn partie · suite en 1.9
  • Résidence des donnéesAnnoncée « par politique », non construite : régions admises par tenant ou par classe, prouvées dans la tracePrévu en 1.9
  • IA de santé : modèles approuvés par type de données, tracesClasses de données, backends admis, ligne de décisionPrévu en 1.9

Les autres domaines

Parlons de votre passerelle

Flexwiz est une jeune entreprise : vous parlez directement avec la personne qui la fonde. Dites-nous ce que vous voulez faire passer par Flexway. Nous parlons de votre infrastructure et de vos exigences de souveraineté numérique.

La prise de rendez-vous en ligne arrive bientôt ; d'ici là, un e-mail suffit.